Sauvegarde et restauration
Chatbotaurus dispose de deux chaînes de sauvegarde qui coexistent :
- la chaîne par scripts (
scripts/backup/), qui exporte PostgreSQL, Valkey, Qdrant et, selon l'hôte, MariaDB vers un stockage S3 européen ; - la chaîne par agents sur l'hôte (spec 114), où un agent installé sur
chaque hôte envoie ses archives à l'orchestrateur intégré à
forge-api.
Le script de retour arrière scripts/backup/rollback.sh permet de revenir de la
seconde à la première sans migration destructive. bash scripts/backup/rollback.sh --dry-run (mode par défaut) vérifie les préconditions et imprime les commandes ;
--appliquer arrête ensuite l'agent et tusd, et --appliquer --conteneurs le fait
par podman stop sur un hôte sans unités Quadlet. Le script s'arrête avant tout arrêt
d'unité si la chaîne par scripts n'est pas présente et valide.
À la fin de ce chapitre, vous saurez sauvegarder chaque composant, restaurer depuis chacune des deux chaînes et prouver qu'une restauration fonctionne.
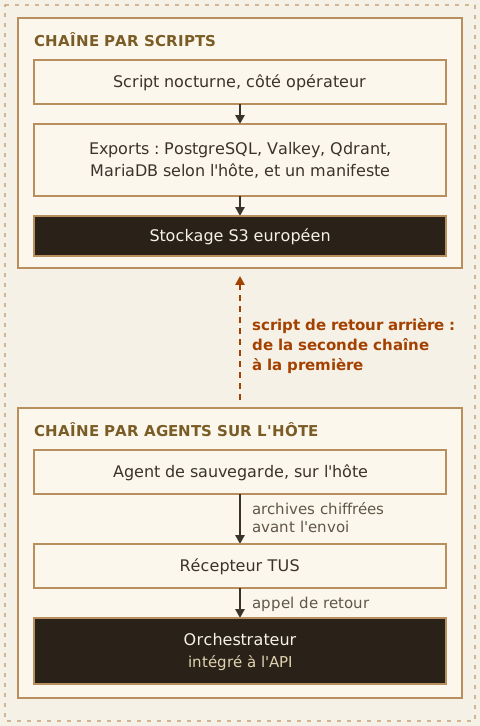
Figure 5 : les deux chaînes de sauvegarde et le retour arrière de la seconde vers la première.
Ce qui est sauvegardé
| Composant | Méthode | Fichier produit |
|---|---|---|
| PostgreSQL | pg_dump au format custom, compression 9 | archive horodatée |
| Valkey | BGSAVE puis copie du dump.rdb | archive horodatée |
| Qdrant | un instantané par collection (API REST, port 6333) | archive horodatée |
| MariaDB | mariadb-dump --all-databases, uniquement si MARIADB_CONTAINER est défini | archive horodatée |
| Manifeste | liste des fichiers et de l'hôte | manifeste horodaté |
Le script échoue franchement (code de sortie 1) si l'export PostgreSQL échoue ou si Qdrant ne renvoie aucune collection : une sauvegarde vide ne sort jamais « verte ».
L'étape Valkey est plus tolérante. Si BGSAVE échoue, ou si
le fichier dump.rdb de Valkey est introuvable sur l'hôte, le script écrit un
avertissement, saute l'étape et sort quand même avec le code 0
(scripts/backup/nightly.sh, étape Valkey). Lisez le journal, ne vous fiez
pas au seul code de sortie.
Sauvegarde automatisée
scripts/backup/nightly.sh est conçu pour tourner chaque nuit, à une heure creuse
sous cron, côté opérateur :
0 <heure> * * * <chemin-d-installation>/scripts/backup/nightly.sh >> <journal-de-sauvegarde> 2>&1
Il lit sa configuration dans l'environnement (variables du stockage S3
européen, PG_*, VALKEY_*, QDRANT_*). Le fichier qui les
porte (fichier d'environnement de la sauvegarde, hors du dépôt, mode 0600) ne se commite jamais.
Le détail des variables et l'installation sont dans
scripts/backup/README.md, livré avec les sources.
Prérequis de nightly.sh et de restore.sh : les outils aws (client S3), curl,
jq, pg_dump, pg_restore et redis-cli, et l'accès réseau à PostgreSQL, Valkey et
Qdrant (le port REST de Qdrant, 6333, pas le gRPC 6334). Variables à exporter : le point
d'accès, la clé d'accès, la clé secrète et le compartiment du stockage S3 ; l'hôte, le
port, l'utilisateur et la base de PostgreSQL, avec le mot de passe fourni par un fichier
désigné par PGPASSFILE ; l'hôte, le port et le mot de passe de Valkey ; l'hôte, le port
et la clé d'API de Qdrant.
- Chiffrement : TLS pendant le transfert, chiffrement SSE-S3 au repos.
- Rétention : 30 jours par défaut (
BACKUP_RETENTION_DAYS) ; le script supprime lui-même les sauvegardes plus anciennes. - Point de reprise : une sauvegarde nocturne réussie donne un point de reprise de 24 heures au plus. C'est l'objectif de point de reprise (RPO) publié sur la page SLA : moins de 24 h. Il reste une cible, pas un constat : l'exercice de restauration de production n'est pas fait (voir Conformité NIS2).
Sauvegarde par agents sur l'hôte (spec 114)
Un agent de sauvegarde tourne sur l'hôte qui porte les données. Il est décrit par :
forge-backup-agent(plan backend) etmcp-backup-agent(plan client), services des fichiers compose derrière le profilbackup, et unités Quadlet correspondantes ;forge-tusd, qui reçoit les archives par le protocole TUS et prévientforge-apipar un appel de retour ;- les routes d'orchestration de
forge-apimontées sous un préfixe interne, réservé au réseau privé, et l'API d'administration sous/api/v1/admin/backups/.
Démarrage en développement :
podman-compose -p chatbotaurus-vps1 --profile backup up -d backup-agent tusd
L'agent reçoit une clé d'enrôlement générée par l'API d'administration.
L'outil forge-ops automatise cette étape :
forge-ops backup status                       # état : agents, cibles, jobs, artefacts
forge-ops backup enroll --name <agent> --origin-host <hôte> --appliquer
forge-ops backup deploy-agent --vps vps1      # unité Quadlet, simulation par défaut
forge-ops backup decrypt <archive.enc>        # déchiffrement hors ligne avec la clé maîtresse
Les archives sont chiffrées avant l'envoi. La rétention est appliquée côté
serveur (30 jours par défaut, réglable par cible) par une
tâche de fond de forge-api ; une passe manuelle est possible avec
POST /api/v1/admin/backups/retention/sweep.
Un stockage objet S3 local, SeaweedFS (forge-seaweedfs, licence
Apache-2.0), sert de banc de test avec un compartiment dédié.
Sauvegarde manuelle
Hors du script nocturne, chaque composant se sauvegarde à la main avec son propre outil.
Après chaque commande, vérifiez que le fichier produit n'est pas vide (ls -l) : une
redirection crée un fichier vide quand l'outil échoue ; les journaux du conteneur disent
pourquoi (voir Problèmes connus).
PostgreSQL
podman exec forge-postgres sh -c 'pg_dump -U "$POSTGRES_USER" -Fc "$POSTGRES_DB"' \
  > chatbotaurus_$(date +%Y%m%d).dump
Qdrant
Une collection à la fois (si la clé API est activée, ajoutez
-H "api-key: $QDRANT_API_KEY") :
curl -fsS http://localhost:6333/collections
curl -fsS -X POST http://localhost:6333/collections/<collection>/snapshots
# Récupérer le fichier : <nom-du-snapshot> est le champ result.name de la réponse précédente
curl -fsS http://localhost:6333/collections/<collection>/snapshots/<nom-du-snapshot> \
  -o qdrant-<collection>-<horodatage>.snapshot
OpenBao
En production (stockage Raft), la procédure est décrite dans le guide d'exploitation du coffre (hors de ce livre) :
bao operator raft snapshot save <dossier-de-sauvegarde>/snap-$(date +%F).snap
Restauration
La restauration suit la chaîne qui a produit l'archive.
Chaîne par scripts
# Un horodatage précis
bash scripts/backup/restore.sh 20260527-030000

# La plus récente
bash scripts/backup/restore.sh latest
Avant de lancer restore.sh : exportez les mêmes variables que pour nightly.sh (section
« Sauvegarde automatisée »), installez aws, pg_restore et redis-cli, et choisissez un
horodatage au format AAAAMMJJ-HHMMSS, nom du dossier de la sauvegarde dans le
compartiment (latest prend la plus récente). Le script lit aussi VALKEY_CONTAINER
(conteneur à redémarrer) et, pour MariaDB, MARIADB_CONTAINER et
MARIADB_ROOT_PASSWORD.
restore.sh télécharge l'archive depuis le S3, contrôle le manifeste, puis
restaure dans cet ordre : PostgreSQL (pg_restore --clean --if-exists),
Valkey (arrêt du conteneur, remplacement du dump.rdb, redémarrage),
MariaDB si un export est présent, puis chaque collection Qdrant par envoi de
l'instantané. Il écrase les données existantes : il attend 10 secondes
avant PostgreSQL et MariaDB pour laisser le temps d'annuler (Ctrl-C).
Résultat attendu : une ligne ... restore OK par composant restauré, des contrôles
finaux (nombre de tables PostgreSQL, nombre de clés Valkey), puis Restore completed successfully from backup <horodatage> et le code de sortie 0. Une ligne [WARN] No ... found ; skipping signifie que ce composant n'était pas dans l'archive ; une ligne
[FAIL] arrête le script avec le code 1. Ensuite : redémarrez forge-api (voir
Gestion des conteneurs), vérifiez GET /api/v1/healthz (voir
Diagnostics et signalement), puis qu'un
utilisateur connu peut se connecter et retrouver son espace.
Chaîne par agents
Une archive produite par un agent se restaure par une demande à l'API d'administration,
jamais par un simple appel : POST /api/v1/admin/backups/restores, avec un compte
administrateur et une organisation active. Le corps porte target_id, artifact_id
(obligatoire), confirmation: true et confirm_target, le nom exact de la cible
réécrit à la main ; reason est facultatif. La réponse est 202 : la demande crée un
travail de restauration et une approbation humaine dans la file des approbations. Tant
que l'approbation n'est pas donnée, l'agent ne restaure rien. Sans confirmation: true,
la réponse est 422 CONFIRMATION_REQUIRED ; sans artifact_id, 422 ARTIFACT_REQUIRED.
GET /api/v1/admin/backups/restores liste les demandes.
PostgreSQL à la main
podman exec -i forge-postgres sh -c \
  'pg_restore -U "$POSTGRES_USER" -d "$POSTGRES_DB" --clean --if-exists' \
  < chatbotaurus_20260527.dump
Qdrant à la main
curl -fsS -X POST \
  -F "snapshot=@qdrant-<collection>-<horodatage>.snapshot" \
  http://localhost:6333/collections/<collection>/snapshots/upload
OpenBao
Voir le guide d'exploitation du coffre (restauration d'un instantané Raft puis descellement).
Répétition de restauration
Une sauvegarde qui n'a jamais été restaurée n'est pas une sauvegarde.
scripts/backup/drill.sh joue un cycle sauvegarde puis restauration sur
une base non critique, compare des compteurs et écrit un rapport daté :
bash scripts/backup/drill.sh --check --hote <alias-ssh>
L'option --check ne vérifie que les préconditions : rien n'est restauré. La répétition
réelle ajoute --restore-hote <alias-ssh> et exige un hôte éphémère de restauration et
l'option
--confirmation ; sans cet hôte, le script le dit au lieu d'inventer un
résultat.
Bonnes pratiques
- Conservez les sauvegardes hors de l'hôte qui porte les données.
- Ne mettez jamais les clés S3, la clé maîtresse des archives ni les clés de descellement OpenBao dans le dépôt.
- Répétez une restauration complète à intervalle régulier et consignez le résultat.
Voir aussi
- Gestion des conteneurs — redémarrer un service après une restauration et lire ses journaux
- Déploiement avec Podman — profils Compose et unités Quadlet qui portent l'agent de sauvegarde
- Problèmes connus — index Qdrant corrompu, OpenBao scellé, stockage S3 fermé par défaut
- Réponse aux incidents — restaurer depuis des sauvegardes saines pendant la phase de reprise
- Conformité NIS2 — exigence de continuité et limite assumée sur l'exercice de production